Comment optimiser votre site web pour la recherche IA : Guide pratique de mise en œuvre GEO/AEO
Découvrez comment optimiser votre site pour Google AI Overviews, ChatGPT Search et Perplexity : accessibilité des robots d'exploration, données structurées, autorité et mesure des performances.
Introduction
Lorsque les moteurs de recherche présentent directement des réponses générées par intelligence artificielle, préserver la visibilité d'un site web exige bien plus que l'alignement sur de simples mots-clés. Les utilisateurs obtiennent fréquemment des réponses complètes et synthétisées sans nécessairement cliquer sur les liens bleus traditionnels.
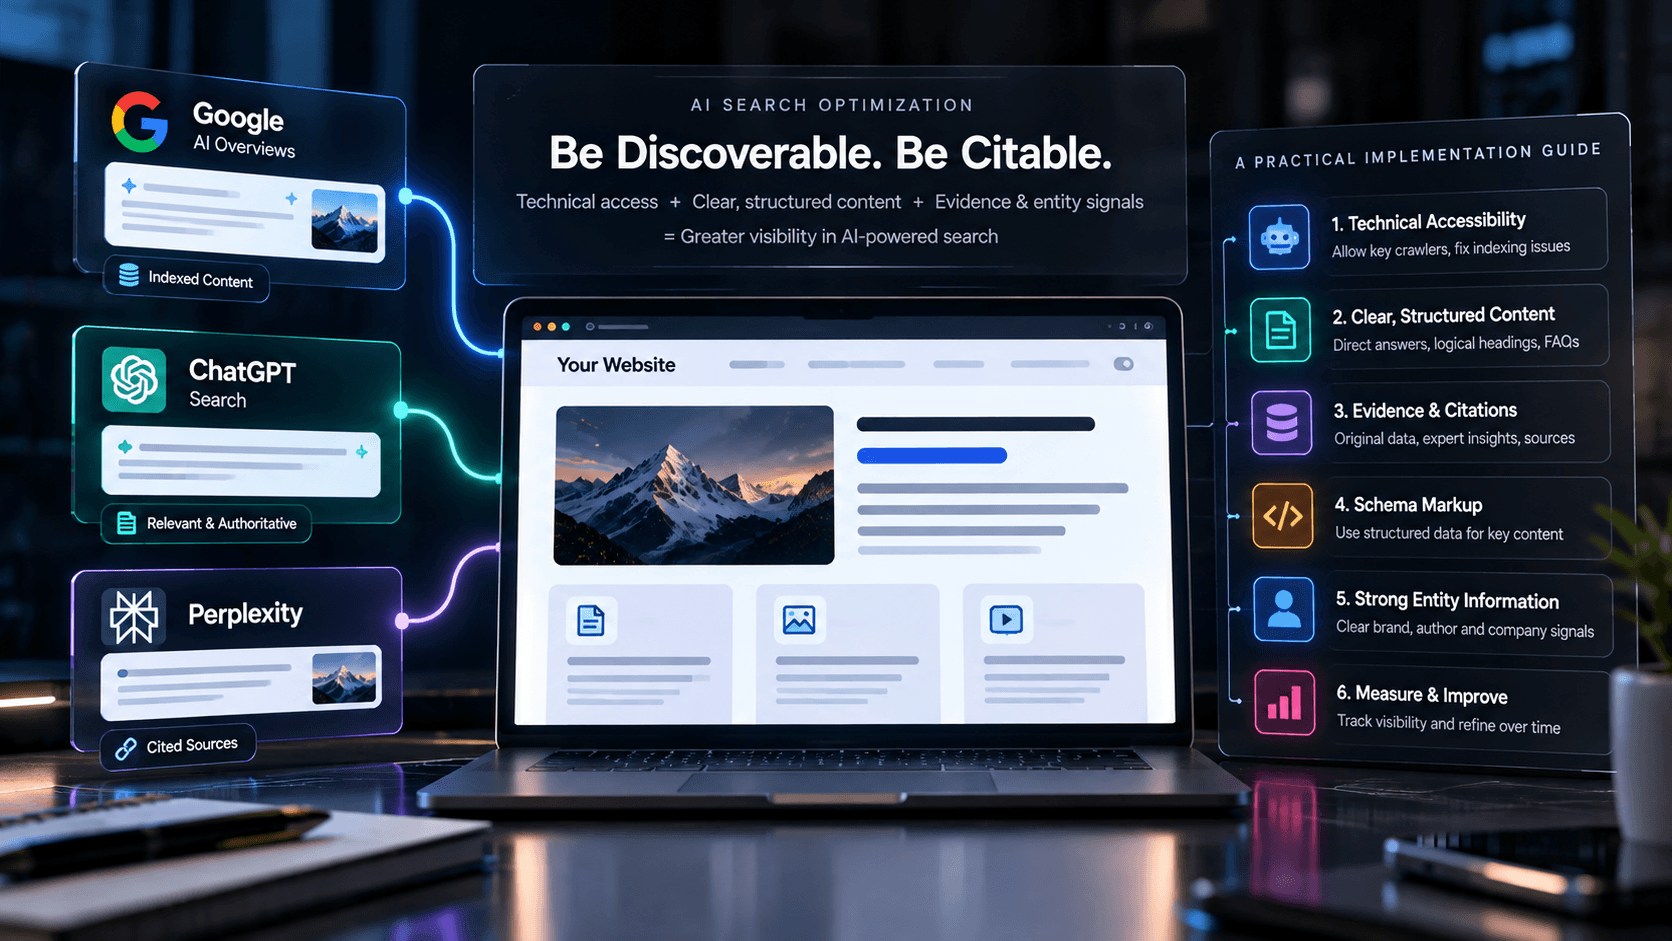
Dans ce nouveau contexte, l'enjeu ne consiste pas à « tromper » des modèles de langage à l'aide de formules magiques, mais à concevoir des pages techniquement accessibles, structurées avec rigueur et faisant autorité sur leur thématique, afin que les moteurs de recherche et les systèmes d'IA puissent facilement extraire et citer votre contenu.
Ce guide détaille le fonctionnement concret des principaux moteurs de recherche assistés par IA, la manière dont ils explorent le web, et les ajustements techniques et éditoriaux indispensables pour maximiser vos opportunités de citation.
Ce que signifie réellement l'optimisation pour la recherche IA
L'optimisation pour les moteurs génératifs (GEO - *Generative Engine Optimization*) et l'optimisation pour les moteurs de réponse (AEO - *Answer Engine Optimization*) désignent l'ensemble des pratiques visant à positionner un site web comme source d'information de référence pour les systèmes d'IA qui génèrent des réponses directes.
Tandis que le SEO traditionnel s'attache à positionner des URL dans une liste de résultats indexés, le GEO et l'AEO ciblent l'inclusion dans des synthèses rédigées par des modèles de langage : les aperçus IA de Google (*AI Overviews*), le mode IA de Google, les réponses de ChatGPT Search et les résumés sourcés de Perplexity.
La différence entre classement et citation
Un résultat traditionnel génère du trafic en incitant l'internaute à cliquer sur une balise de titre et une méta-description. À l'inverse, un moteur de réponse synthétise l'information de multiples pages pour formuler un paragraphe complet, accompagné de renvois ou de cartes de sources.
Être cité comme référence exige une clarté factuelle irréprochable : si votre contenu est ambigu, enseveli sous du jargon promotionnel ou inaccessible aux robots d'exploration, le modèle privilégiera une source concurrente qui formule les réponses de manière directe et vérifiable.
L'optimisation pour la recherche IA ne remplace pas le SEO traditionnel : elle en constitue l'extension naturelle, reposant sur les mêmes piliers fondamentaux que sont l'indexabilité technique, la qualité éditoriale et la crédibilité de l'émetteur.
Comment Google AI Overviews, ChatGPT Search, Perplexity et Bing découvrent le contenu
Optimiser un site pour la recherche par intelligence artificielle exige d'abord de comprendre que les différentes plateformes découvrent, explorent et traitent les pages web de manières très distinctes. Traiter « la recherche par IA » comme un système homogène conduit inévitablement à disperser ses efforts.
Google : L'indexation standard alimente AI Overviews
Comme le précise la documentation officielle de Google sur les fonctionnalités d'IA, il n'existe aucun robot d'exploration dédié à l'IA ni aucun formulaire d'inscription distinct pour Google AI Overviews. Google puise directement ses sources dans son index de recherche classique alimenté par Googlebot. Si une page est explorée, indexée et conforme aux règles fondamentales de Google Search, elle est techniquement éligible pour apparaître comme référence dans AI Overviews et dans le mode IA.
Les éditeurs souhaitant encadrer l'affichage de leurs contenus peuvent utiliser les balises méta robots standard telles que `nosnippet`, `max-snippet` ou l'attribut `data-nosnippet` sur des portions précises du DOM. Respecter les exigences techniques de Google rend une page éligible, mais ne garantit en aucun cas sa sélection ou sa citation dans AI Overviews.
ChatGPT Search : Des robots distincts pour la recherche et l'entraînement
OpenAI sépare strictement ses opérations d'exploration entre plusieurs agents d'utilisateurs aux rôles définis, détaillés dans la documentation des robots d'OpenAI et le guide de ChatGPT Search :
- OAI-SearchBot : Explore le web spécifiquement pour indexer les pages et afficher des liens d'attribution dans ChatGPT Search. Il ne sert pas à l'entraînement des modèles de fondation. Autoriser OAI-SearchBot dans votre fichier `robots.txt` et vérifier vos règles de pare-feu permet à votre site d'être cité dans ChatGPT Search.
- GPTBot : Collecte les données publiques du web pour entraîner les futurs modèles d'OpenAI. Vous pouvez interdire GPTBot dans `robots.txt` si vous refusez que vos données soient utilisées pour l'entraînement, sans que cela n'affecte la présence de votre site dans ChatGPT Search.
- ChatGPT-User : Effectue des requêtes ciblées en temps réel lorsqu'un utilisateur soumet une invite nécessitant une navigation active sur le web ou l'analyse d'une URL spécifique.
Perplexity : Recherche en temps réel et respect du robots.txt
Perplexity s'appuie sur deux robots principaux, documentés dans la documentation des crawlers de Perplexity et son guide sur le robots.txt :
- PerplexityBot : Robot d'exploration qui découvre et indexe les contenus pour répondre aux requêtes de recherche et générer des citations de sources. Perplexity confirme ne pas utiliser ces données pour entraîner des modèles de fondation.
- Perplexity-User : Réalise des extractions en direct pour répondre aux questions des internautes au cours de sessions de navigation interactives.
Perplexity respecte scrupuleusement les directives d'exclusion standard de `robots.txt`. Si vous bloquez PerplexityBot, ce robot n'extraira pas vos contenus. Toutefois, à l'instar des moteurs classiques, Perplexity peut mentionner une marque ou un fait établi si l'information est corroborée par des sources tierces déjà indexées.
Microsoft Copilot et Bing : Indexation web, IndexNow et outils de diagnostic
Microsoft Copilot (anciennement Bing Chat) élabore ses synthèses et ses liens de citation directement à partir de l'index web de Bing. Contrairement à des robots d'extraction expérimentaux, Microsoft s'appuie sur une infrastructure de recherche pérenne :
- Exploration et indexation par Bingbot : Bingbot analyse les contenus conformément aux règles pour les webmasters de Microsoft Bing. Les pages doivent être accessibles et indexées par Bingbot pour pouvoir être évaluées et citées dans Microsoft Copilot.
- Bing Webmaster Tools et Inspection de l'URL : L'outil d'inspection de l'URL dans Bing Webmaster Tools (documentation de l'outil d'inspection Bing) permet de vérifier l'état d'exploration, le statut d'indexation, le DOM HTML effectivement rendu, la date de découverte et les erreurs d'exploration.
- Sitemaps XML et protocole IndexNow : Alors que les sitemaps XML assurent une découverte périodique, le protocole IndexNow (développé par Microsoft et Yandex) permet aux sites d'envoyer une notification instantanée dès qu'une URL est publiée, mise à jour ou supprimée, via une simple clé API. Précision essentielle : IndexNow sollicite une priorité d'exploration immédiate, mais ne force pas l'indexation et ne garantit aucunement l'affichage dans les résultats ou les réponses de Copilot.
- Rapports de visibilité IA dans Bing Webmaster Tools : Les rapports sur les performances de recherche de Bing Webmaster Tools séparent les données de la recherche web traditionnelle des interactions dans Copilot/Chat. Cependant, un bon positionnement organique classique ou un volume élevé d'impressions ne prouve pas directement qu'une page sera citée dans une synthèse générative.
L'accessibilité ouvre la porte, le contenu mérite la citation
Sur l'ensemble de ces quatre plateformes, l'accès des robots est un prérequis absolu sans lequel aucune évaluation n'est possible. Cependant, l'accès technique ne garantit jamais une citation. La sélection dépend de la pertinence contextuelle, de la clarté informative et de l'autorité perçue au moment précis de la génération de réponse.
Étape 1 — Diagnostiquer l'accessibilité de votre site pour les systèmes d'IA
Avant de remanier vos contenus éditoriaux, vérifiez que les moteurs de recherche et les robots d'IA peuvent récupérer et afficher techniquement vos pages. La majorité des défauts de visibilité résultent de blocages d'infrastructure évitables.
Diagnostiquer l'exploration et l'indexation dans Search Console et Bing Webmaster Tools
Consultez les rapports d'indexation de Google Search Console et Bing Webmaster Tools en distinguant nettement exploration et indexation :
- Bloquée par le fichier robots.txt : Une règle robots.txt contrôle l'exploration et n'empêche pas à elle seule l'indexation. Elle interdit à Googlebot ou Bingbot de visiter l'URL, mais le moteur peut néanmoins l'indexer si d'autres pages pointent vers elle. En revanche, le moteur ne pouvant pas lire le contenu ni détecter une balise `noindex`, il ne peut ni évaluer ni citer ce texte dans AI Overviews ou Copilot.
- Exclue par la balise 'noindex' : La directive `noindex` empêche l'affichage dans les résultats de recherche. Pour que cette règle soit prise en compte, les robots doivent impérativement pouvoir explorer la page ; si l'URL est bloquée dans robots.txt, le robot ne verra jamais la directive. Vérifiez qu'aucune directive de préproduction (comme un en-tête `X-Robots-Tag: noindex`) ne soit restée active en production.
- Explorée, actuellement non indexée : La page a été visitée mais n'a pas été retenue dans l'index. Une URL non indexée ne peut généralement pas apparaître dans les résultats ordinaires ni servir de source à une réponse générative, même si ce statut peut évoluer au fil des réévaluations de qualité du site.
- Inspection de l'URL dans Bing Webmaster Tools : Utilisez cet outil pour constater si Bingbot rencontre des erreurs d'exploration, visualiser le DOM rendu et confirmer l'indexation effective dans l'index de Bing.
- Balises canoniques : Vérifiez que chaque URL prioritaire spécifie sa propre URL canonique autoréférencée sans pointer vers une page divergente.
Vérifier les règles du fichier robots.txt
Analysez votre fichier en ligne sur `votredomaine.com/robots.txt`. Contrôlez les autorisations pour `Googlebot`, `Bingbot`, `OAI-SearchBot`, `PerplexityBot` et `ChatGPT-User`. Veillez à ce que les règles de blocage visant les dossiers d'administration ou scripts internes ne bloquent pas accidentellement des articles de blog, des guides techniques ou des pages de ressources.
Contrôler les pare-feu applicatifs (WAF)
Les pare-feu de sécurité (Cloudflare, AWS WAF, Fastly) et les limites de fréquence assimilent fréquemment les robots d'IA à du trafic malveillant. Vérifiez vos journaux d'accès pour identifier d'éventuelles erreurs 403 Forbidden ou 429 Too Many Requests appliquées à des robots certifiés, et intégrez les plages IP officielles dans vos listes d'autorisation.
Valider le rendu côté serveur (SSR)
Les robots d'IA disposent d'un budget de calcul strict. Si votre site repose entièrement sur une exécution JavaScript côté client pour afficher ses titres, textes et tableaux, certains robots n'indexeront qu'une structure vide. Utilisez les outils d'inspection d'URL de Google et Bing ou effectuez une requête curl sur le code source brut pour vous assurer que le contenu textuel est immédiatement disponible dans le code HTML initial fourni par le serveur.
Étape 2 — Structurer des pages faciles à interpréter
Les modèles de langage découpent les pages en fragments textuels sémantiques (*chunks*). Plus votre structure éditoriale est claire et directe, plus l'extraction d'extraits pertinents devient fluide.
La méthode de la pyramide inversée
Adoptez une structure rédactionnelle où la réponse directe précède les explications détaillées :
- Énoncé clair en tête de section : Répondez à la problématique posée dès la première phrase suivant le sous-titre (H2 ou H3).
- Développement technique : Apportez ensuite les justifications contextuelles, les mécanismes de fonctionnement et les conditions d'application.
- Synthèses visuelles : Utilisez des listes à puces ou des tableaux pour résumer les données comparatives ou chiffrées.
Créer des blocs factuels autonomes
Chaque section doit pouvoir être comprise indépendamment du reste de la page. Les modèles d'IA sélectionnent souvent un unique paragraphe pour répondre à une question ciblée. Évitez les formules de transition vagues comme « Comme mentionné ci-dessus » et privilégiez la répétition explicite des entités nommées (technologies, protocoles, méthodes).
Étape 3 — Renforcer les entités sémantiques, la paternité et la confiance
Les moteurs de recherche modernes ne traitent plus les pages comme de simples sacs de mots-clés, mais comme des assertions reliées à des entités connues au sein d'un graphe de connaissances (*Knowledge Graph*).
Établir une paternité incontestable (E-E-A-T)
Pour mériter d'être cité sur des sujets pointus, un site web doit démontrer son expertise et sa légitimité :
- Biographies d'auteurs complètes : Identifiez clairement les auteurs, leur expérience professionnelle concrète et leurs profils externes (LinkedIn, publications spécialisées).
- Mentions d'entreprise et informations légales : Affichez lisiblement l'identité de l'organisation, ses coordonnées et son historique d'activité.
- Sources vérifiables : Liez votre contenu aux documentations officielles, études académiques ou textes réglementaires de référence plutôt que d'émettre des affirmations non étayées.
Étape 4 — Déployer des données structurées avec discernement
Le balisage Schema.org permet aux machines d'interpréter sans ambiguïté les relations entre les données d'une page.
Bien qu'il ne s'agisse pas d'une garantie de citation, les données structurées facilitent l'identification des entités et des concepts clés par les moteurs de recherche.
Schémas recommandés
- `Article` ou `TechArticle` : Déclare le titre officiel, la date de publication, la date de modification et l'auteur.
- `FAQPage` : Structure les questions-réponses fréquentes, offrant un format idéal pour l'extraction de réponses directes.
- `Organization` : Établit l'identité de votre entreprise, son logo, ses profils sociaux et ses domaines d'activité.
- `Product` et `HowTo` : Fournissent des caractéristiques précises et des étapes séquentielles directement exploitables par les moteurs génératifs.
Veillez à ce que le contenu déclaré dans le JSON-LD corresponde fidèlement au texte visible sur la page pour les utilisateurs réels.
Étape 5 — Mesurer les performances avec des indicateurs réels
Mesurer l'impact de la recherche IA nécessite de combiner plusieurs sources de données, les plateformes ne fournissant pas toutes des tableaux de bord isolés.
Trafic référent dans vos outils d'analyse web
Surveillez dans vos outils de mesure d'audience (Google Analytics, Plausible, PostHog) les visites en provenance de domaines référents spécifiques :
- `chatgpt.com` et `android-app://com.openai.chatgpt`
- `perplexity.ai`
- `claude.ai`
- `copilot.microsoft.com`
Configurez des segments personnalisés pour analyser le taux d'engagement et les conversions des visiteurs provenant de ces sources.
Données d'impression dans Google Search Console
Actuellement, Google regroupe les clics et impressions issus des AI Overviews au sein des métriques de recherche web globales. Une augmentation sensible des impressions sur des requêtes informationnelles de longue traîne, associée à un taux de clic (CTR) stable ou en évolution, peut témoigner d'une présence accrue dans ces modules génératifs.
Liste de contrôle pour l'optimisation dans la recherche IA
Utilisez cette liste de contrôle pour auditer l'accessibilité technique, la structure rédactionnelle et les signaux de confiance sur vos pages stratégiques :
- (Unchecked) robots.txt : Assurez-vous que `Googlebot`, `Bingbot`, `OAI-SearchBot`, `PerplexityBot` et `ChatGPT-User` ne sont pas involontairement bloqués sur vos contenus publics utiles.
- (Unchecked) WAF et pare-feu : Contrôlez les journaux pour vérifier l'absence d'erreurs 403 Forbidden ou 429 Too Many Requests ciblant les robots légitimes d'IA et de recherche.
- (Unchecked) Rendu côté serveur : Vérifiez que les titres H1-H3, le corps du texte et les tableaux de données sont présents dans le HTML initial sans dépendre du JavaScript client.
- (Unchecked) Statut d'indexation : Confirmez dans Search Console et Bing Webmaster Tools que vos pages prioritaires sont indexées, sans balise `noindex` résiduelle ni canonique divergente.
- (Unchecked) Déploiement d'IndexNow : Adoptez le protocole IndexNow pour notifier immédiatement Bing et Yandex des créations, modifications ou suppressions d'URL.
- (Unchecked) Réponses directes : Placez la réponse clé en début de section avant de développer les explications techniques, les justifications et les nuances.
- (Unchecked) Hiérarchie des titres : Structurez vos pages avec des intertitres H2 et H3 clairs, formulés comme des questions naturelles ou des concepts explicites.
- (Unchecked) Sources primaires : Appuyez toutes vos données chiffrées et recommandations techniques sur des citations vers les documentations d'origine et études de référence.
- (Unchecked) Cohérence de l'entité : Harmonisez les informations relatives à votre entreprise (dénomination légale, dirigeants, contacts, services) sur votre site et vos profils tiers vérifiés.
- (Unchecked) Attribution de l'auteur : Intégrez des signatures d'auteurs claires accompagnées de biographies attestant d'une expertise reconnue sur les guides techniques.
- (Unchecked) Données structurées : Implémentez des schémas JSON-LD valides (`Article`, `Organization`, `BreadcrumbList`), en parfaite conformité avec le contenu visible.
- (Unchecked) Mesure et suivi : Analysez les données Search Console et Bing Webmaster Tools, mesurez le trafic référent issu de `chatgpt.com` et `perplexity.ai`, et tenez un journal de sondage d'invites trimestriel.
Conclusion
La visibilité dans la recherche assistée par IA repose sur une ingénierie rigoureuse et des contenus à forte valeur ajoutée : s'assurer que les robots accèdent à vos pages sans encombre et fournir des informations claires et vérifiables dans lesquelles les utilisateurs et les moteurs de réponse peuvent avoir confiance. À mesure que les interfaces de recherche se transforment, les organisations qui maintiennent une accessibilité technique irréprochable, une paternité transparente et un contenu approfondi préserveront leur visibilité sur les plateformes traditionnelles et génératives.
Pour auditer l'accessibilité de vos contenus pour les robots, vos données structurées et votre performance de recherche, découvrez les services d'optimisation SEO de Belk Digital.
Documentation et sources officielles
- Google Search Central: Fonctionnalités d'IA et recherche Google
- Google Search Central: Règles fondamentales de Google Search
- OpenAI: Vue d'ensemble des robots d'exploration d'OpenAI
- OpenAI: Guide de ChatGPT Search
- Perplexity AI: Documentation des robots d'exploration de Perplexity
- Perplexity AI: Respect du robots.txt par Perplexity
- Microsoft Bing: Règles pour les webmasters de Microsoft Bing
- Microsoft Bing: Outil d'inspection de l'URL de Bing
- IndexNow: Documentation du protocole d'indexation instantanée
Questions Fréquentes
Besoin d'un expert pour cela ?
Si vous cherchez à mettre en œuvre ces stratégies pour votre entreprise, notre équipe peut vous aider à planifier, construire et évoluer en toute confiance.
ContactPrêt à Transformer Votre Présence Digitale?
Let's discuss how we can help you achieve your digital goals and create an exceptional online presence.